Sponsoreret indhold
Positiv forstærkning: Forstå din hunds belønningssystem
Der er en grund til, at nogle hunde arbejder for en godbid, som om deres liv afhang af det, mens andre knap nok gider rejse sig.
Det handler sjældent om, hvor sulten hunden er lige der og da. Det handler om, hvordan hjernen har lært at forvente belønning. Interessant nok er det stort set den samme mekanisme, der får mennesker til at blive ved med at spille casinospil, selvom udfaldet er usikkert hver eneste gang. Hjernen elsker uforudsigelighed, både hos hunden på gulvtæppet og hos mennesket foran skærmen. For hundeejere, der gerne vil have deres træning til at sidde fast, er den viden faktisk ret nyttig.
Dopamin og forventning
Når en hund får en godbid, ros eller lidt leg, frigives der dopamin. Det ved de fleste allerede. Men det, mange overser, er, at dopaminet i høj grad kommer allerede i forventningens øjeblik, altså inden belønningen overhovedet er givet. Får hunden en godbid hver eneste gang, også når det ikke er med træning for øje, aftager motivationen typisk efter et stykke tid. Sker det derimod uregelmæssigt, holder interessen sig langt bedre.
Fast belønning versus variabel belønning
B.F. Skinner undersøgte dette allerede i 1930’erne og 1940’erne gennem sine forsøg med dyr i det, der senere blev kendt som Skinner-bokse. Han fandt, at dyr, som blev belønnet uregelmæssigt, blev ved med at arbejde langt mere ihærdigt end dyr, der kunne regne belønningen ud på forhånd.
Nogle af hans forsøgsdyr trykkede på en pind hundredvis af gange i træk, bare fordi de aldrig vidste, hvornår den næste belønning dukkede op. Samme mønster gælder for hunde i dag. En hund, der kun engang imellem får en godbid for at komme, når man kalder, reagerer ofte hurtigere og mere pålideligt, end en hund der kender rutinen udenad og ved præcis, hvad den kan forvente.
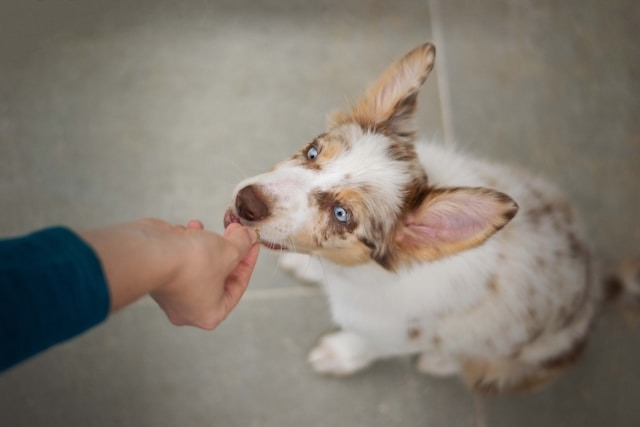
![]()
Læs også:
Sådan bruger man det i praksis
I praksis kan man starte med at belønne hver gang, mens hunden lærer en ny øvelse. Efterhånden som øvelsen sidder godt fast, trækker man langsomt belønningen tilbage, så den kun kommer hver anden eller tredje gang. Det skaber typisk en mere robust adfærd, end konstant belønning gør, fordi hunden ikke kan gennemskue mønsteret og derfor bliver ved med at prøve. Timing spiller også en stor rolle her, for belønningen bør helst komme inden for få sekunder efter den rigtige handling, ellers har hunden svært ved at koble de to sammen, og hele øvelsen mister en del af sin effekt.
Mere end bare en godbid
Mad er langt fra den eneste mulighed. Ros, et kort kærtegn eller leg med et yndlingslegetøj virker ofte lige så godt, især hos hunde, der ikke er specielt madglade. En del trænere skifter bevidst mellem flere typer belønning i samme session, dels for at holde hundens opmærksomhed, dels for at undgå, at én bestemt godbid mister sin værdi. Princippet minder faktisk om, hvordan variation i en oplevelse kan holde interessen oppe over tid, uanset om det gælder en hund eller et hvilket som helst andet væsen, der reagerer på skiftende stimuli.
Det handler ikke om at snyde hunden
Nogle får det indtryk, at variabel belønning er en form for manipulation, men det er egentlig bare en måde at arbejde med, hvordan hjernen allerede fungerer. Adfærdsstudier peger på, at hunde trænet med positiv og variabel forstærkning som regel virker mere afslappede og har et tættere forhold til deres ejer, sammenlignet med hunde trænet gennem straf. Målet er ganske enkelt at gøre træningen til noget, hunden selv finder spændende, frem for en opgave, den bare udfører for at slippe for ubehag.
Denne forståelse rækker langt ud over hundetræning. De samme grundlæggende mekanismer, der holder en hund fokuseret under en øvelse, ligger dybt forankret i hvordan hjernen generelt reagerer på uforudsigelighed. Den praktiske konsekvens for hundeejere er egentlig ret enkel. Variation, god timing og lidt tålmodighed giver som regel bedre og mere holdbare resultater end faste rutiner nogensinde kan.
Vores team kan have anvendt AI til at assistere i skabelsen af dette indhold, som er gennemgået af redaktørerne.
![]()
Læs også: